Изпълнителят ви праща оферта с ред „изготвяне на llms.txt за AI видимост“, и редът звучи технически, звучи нужно и си има цена.
Ето позицията на най-големия играч.
За появата в Google Търсене, включително в AI функциите му, не са нужни нови файлове за AI търсачки, AI текстови файлове, маркировка или Markdown.
Защото самото Google Търсене не ги ползва.
Файлът llms.txt е предложение за кратък текстов файл в корена на сайта, който описва сайта и изброява важните му страници.
Идеята е езиковите модели, тоест програмите като тази зад ChatGPT, и агентите да четат него, вместо да се оправят с HTML, менюта и скриптове на всяка страница.
Бърз отговор
Файлът llms.txt е предложение на общността, а не стандарт на търсачка, тоест заглавие, кратко описание и списък с връзки в корена на сайта. Google го пренебрегва, а другите платформи не са заявили, че го четат.
Какво всъщност значи
Предложението е просто. В Markdown се слага файл /llms.txt, който дава удобно за езикови модели съдържание. Името и мястото са по образец на robots.txt и на картата на сайта, един познат файл в корена.
Смисълът обаче е обратен на robots.txt.
Той казва на роботите какво да не пипат. Файлът llms.txt казва на агентите откъде да започнат.
Бъркат го с картата на сайта.
Картата изброява всички адреси за търсачката, и ролята, която на файла му се приписва, вече я върши самата карта от години: коя карта роботите четат наистина.
Файлът llms.txt е кратък, подбран и написан така, че езиков модел да го прочете като бележка, не като таблица.
Защо това ви засяга
Представете си, че печатате хубава брошура и я оставяте на рецепцията.
Най-големият ви клиент минава и казва на висок глас: „Ние брошури не взимаме, четем сайта.“
Останалите клиенти минават мълчаливо.
Никой не е казал, че я взима. Никой не е казал, че не я взима.
Файлът не е стъпка от това, което AI търсачката прави, преди да ви цитира, затова не носи цитирания.
Това е положението с llms.txt днес.
Google е казал на висок глас: не е нужно да създавате нови машинно четими файлове, AI текстови файлове или маркировка, за да се появите в AI функциите му.
Добавя, че е напълно допустимо да поддържате такива файлове за други услуги, които ги ползват.
И че за Google Търсене това нито ще навреди, нито ще помогне.
Ето какво значи това при магазин за осветителни тела в София, който е платил за файла:
| Клиентът пита | Какво става на екрана |
|---|---|
| В Google с AI отговор: „лампа за над кухненски плот“, преди файла | Магазинът е в отговора, защото страницата му е в индекса на търсенето. |
| Същото, след файла | Същото. Google не е отворил файла и нищо не се е променило. |
От другата страна стои самото предложение, което описва разпространение, не четене.
Хиляди сайтове публикуват llms.txt, платформите за документация го правят автоматично, и OpenAI, Anthropic и Google го публикуват за собствената си документация за разработчици.
Това казва кой го публикува. Нито OpenAI, нито Anthropic, нито Google са заявили, че продуктите им четат llms.txt от чужди сайтове.
Файлът още не е стандарт, но вече е практика.
Файлът още не е стандарт, но сайтове, които AI търсачките посочват, вече го подават, включително на български домейни.
Как изглежда на практика
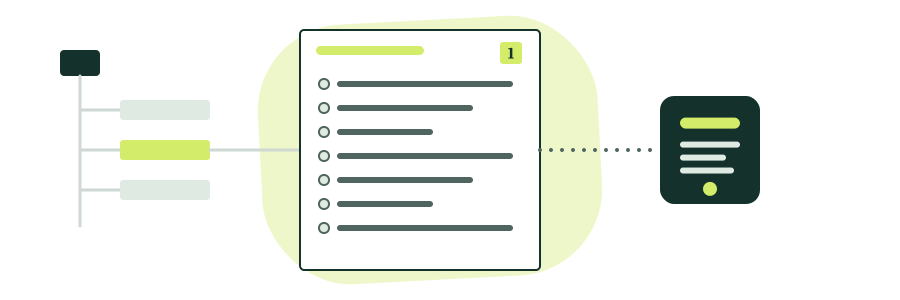
Файлът има проста структура. Задължително е само едно, заглавие с името на сайта. По избор следват:
- Кратко описание в един абзац.
- Свободен текст с подробности.
- Раздели със списъци от връзки, всяка връзка с име, адрес и бележка. Раздел с име „Optional“ е за второстепенни връзки, които агент може да пропусне, когато няма място.
Предложението добавя и втора практика: страниците, които агент може да поиска, да имат чисто текстово копие на същия адрес с добавено .md. Това вече не е един файл, а огледално копие на сайта.
Проверката дали някой го чете е една: дневникът на сървъра.
Заявки към /llms.txt и от кое име идват. Без такива записи няма доказателство, че файлът се ползва. А кои роботи идват и защо е отделен въпрос, с отделен отговор за всеки от тях.
Какво струва и какво носи
За Google решението е взето вместо вас: файлът е без значение. Не се прави заради Google. Не се плаща заради Google.
За другите системи няма официално потвърждение.
Ако някой обещава, че ChatGPT или Claude ще четат файла ви, поискайте къде OpenAI или Anthropic са го казали официално.
Няма ли такова място, обещанието е предположение.
Разходът е един текстов файл и поддръжката му, а рискът да го няма е също толкова малък.
Единственият реален риск е файлът да казва нещо различно от самите страници.
Присъствието в AI функциите на Google минава през индекса на търсенето, не през llms.txt.
Ако някой ви го продава като „оптимизация за ChatGPT“, ето какво реално се прави за ChatGPT.
Кое правило е сложено във вашия сайт днес, проверяваме преди всичко друго.
Накъде отива
Заявените позиции са 2 и не се пресичат. При Google търсенето не ползва файла. Предложението отчита 2 години разпространение и автоматично създаване от платформи за документация.
Дали OpenAI, Anthropic или Perplexity четат файла от чужди сайтове, не е заявено официално.
Каквото се твърди отвъд това, е предположение. Нужен ли ви е, в 3 решения според вида на сайта, с това, което струва и това, което не носи.
2 примера
Магазин за осветителни тела получава офертата от началото.
Собственикът отваря дневника на сървъра за последния месец и търси /llms.txt. Нито една заявка.
Файлът може да бъде направен за час и няма да навреди, но никой не го е търсил и никоя от големите компании не е обещала да го търси.
Парите отиват другаде.
Вторият пример е самият Google. Той изброява като трикове за пренебрегване нарязването на съдържанието, създаването на ненужни AI текстови файлове като llms.txt и търсенето на неистински споменавания.
Въпросите, които ще ви хрумнат
Ако направя llms.txt, значи ли, че ще се появя в AI Overviews?
Не.
Търсенето на Google не ползва такива файлове и те нито помагат, нито вредят.
Появата в AI Overviews минава през обикновеното индексиране на страниците, тоест през това Google да ги е прочел и записал.
Кое се прави първо, llms.txt или robots.txt?
robots.txt.
Той е стандарт, който търсачките и повечето AI роботи спазват, и грешка в него може да ви извади от търсенето.
llms.txt е предложение на общността, което никоя търсачка не изисква. Ако ви остане час, направете го, но не плащайте за него като за нещо, което носи видимост.
Как да проверя за 10 минути дали някой изобщо чете файла ми?
Отворете дневника на сървъра или таблото на хостинга и потърсете заявки към /llms.txt.
Ако има такива, ще видите от кой робот идват и колко често. Ако няма нито една за последния месец, никой не го е търсил, и това е отговорът на офертата.
Довечера потърсете в дневника на сървъра си /llms.txt. Ако някой го е поискал, ще знаете кой. Ако никой, знаете какво да отговорите на офертата.